はじめに
自社のサイトの記事をAIの学習に使われたくないものの、ロボットを止めてAI検索に社名が出なくなるのは困る。robots.txt の設定を前に、こう迷った経験はないでしょうか。
Google と Microsoft が、AI学習を拒否する意向を1か所で伝える共通の指定に対応すると発表し、OpenAI も対応すると報じられています。本記事では、その2行の書き方と、AI検索への影響、各社がいつから対応するかを解説します。スマートエイトは法人向けの生成AI研修・AI開発・AI顧問の会社で、自社のサイトでもAI検索の対策を続けています。
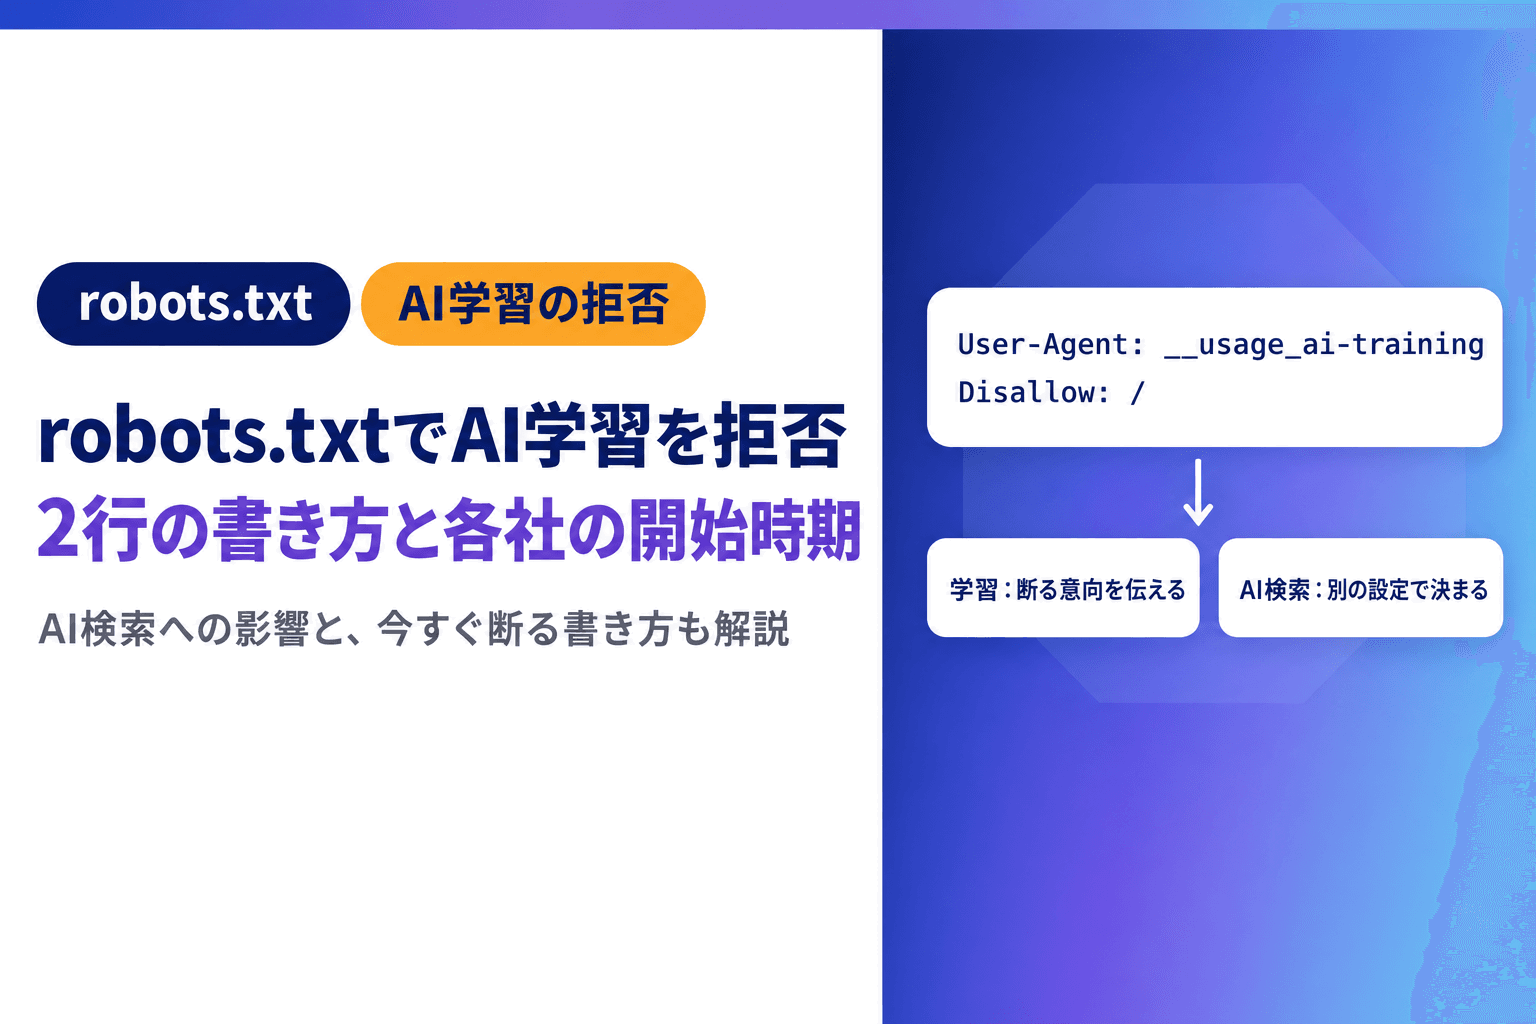
結論として、共通の指定は学習を断る意向を伝えるもので、ロボットの読み込みを止める指定ではありません。AI検索への掲載は別の設定で決まるため、学習だけを断れます。注意が要るのはGoogleのGeminiアプリで、回答への掲載が学習と同じ設定でつながっています。
各社がこの指定を読み始めるのはこれからなので、今すぐ断るなら会社ごとの名前も併せて書きます。
本記事は、2026年11月1日時点の公開情報と報道をもとにしています。
robots.txtでAI学習を拒否する共通の指定とは|何が1か所にまとまったか
学習を断るには、これまで相手の会社ごとにロボットの名前を書く必要がありました。共通の指定では、この名前が1つにまとまります。変わる点と変わらない点を分けて見ていきます。
これまでと何が変わるのか?
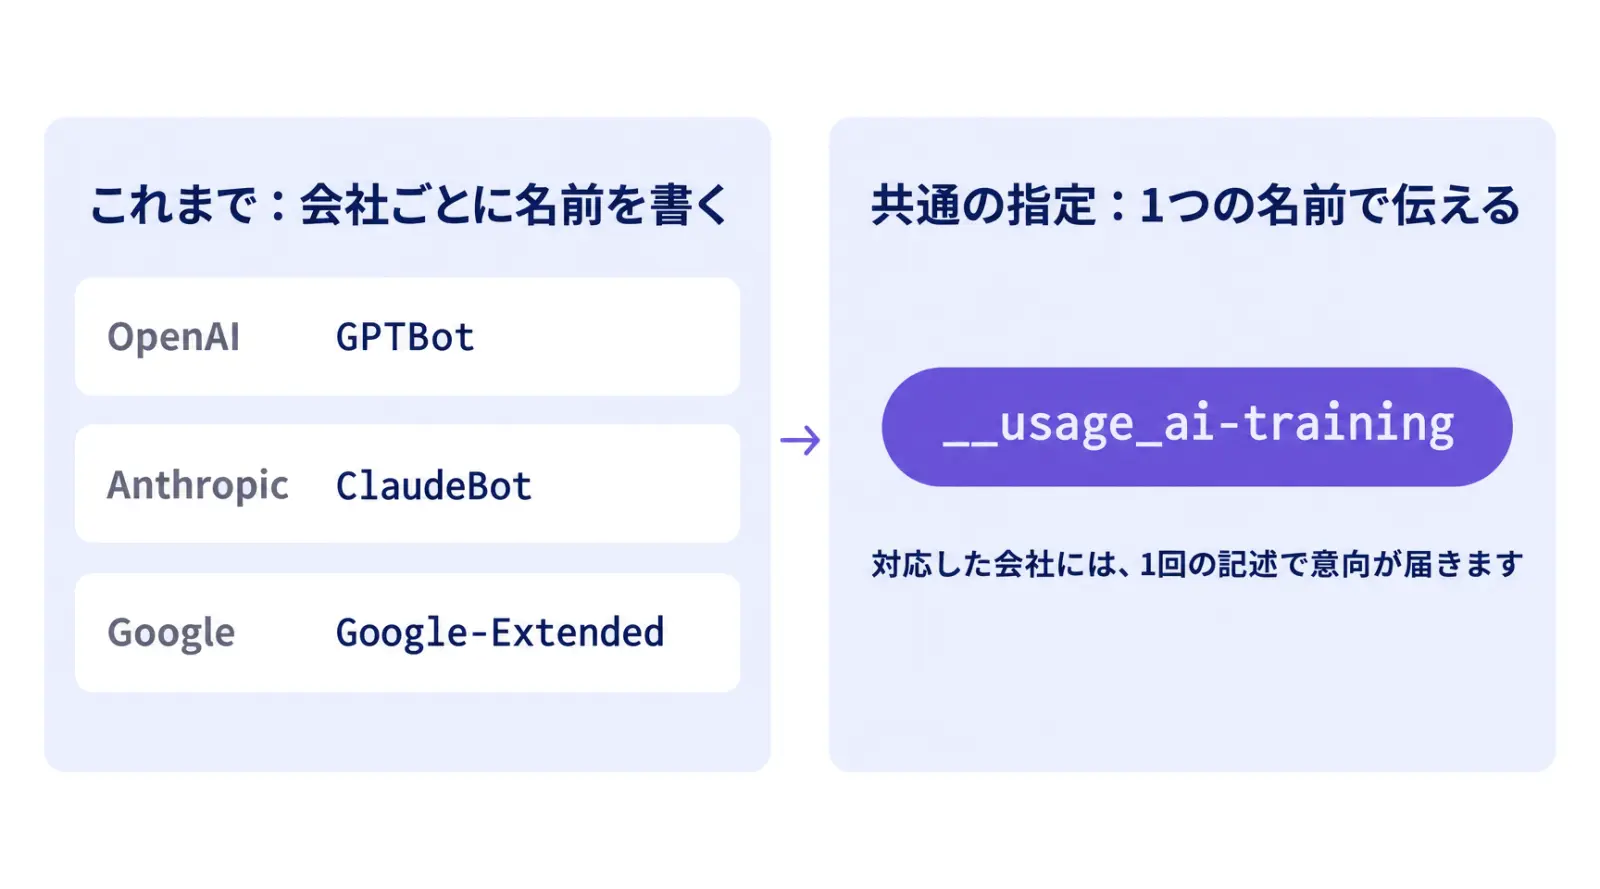
robots.txt* は、サイトを読みに来るロボットへの指示を書くファイルです。クローラーとも呼ばれるこのロボットは会社ごとに名前が違います。学習を断るなら、OpenAIは学習用の GPTBot*、Anthropicは ClaudeBot を指定してきました。
共通の指定では、__usage_ai-training という1つの名前を書きます。対応した会社には、1回の記述で意向が届きます。Googleは2026年10月30日に、複数のAI提供者へ1度に意向を示せる仕組みとして発表しました。
元になっているのは、Anthropicの担当者が同じ日に標準化団体へ出した提案の文書です。正式な標準として決まった物ではなく、各社が先に対応を進めている段階です。
何を断ったことになるのか?
断る対象は、文章や画像を作る生成AIのモデルの中身を、サイトの内容で書き換える使い方です。提案の文書は、この使い方だけを「AI学習」と定めています。
分類や順位付け、点数付けだけに使うモデルは、対象に入りません。「AIに使わないでほしい」という広い意思表示ではなく、学習という1つの用途に絞った指定だと考えると分かりやすくなります。
質問に答えるときにページを読みに来る使い方も、学習とは別の用途です。AIの回答の材料に使われるかどうかは、多くの場合は別の設定で決まります。2章で会社ごとに見ていきます。
ロボットの読み込みは止まるのか?
止めるための指定ではありません。この指定が決めるのは、読み込みの可否ではなく内容の使い方です。今の検索ロボットは、知らない名前のまとまりとして読み飛ばすので、Google検索などの読み込みにも影響しません。
例えば社労士事務所が、時間をかけた解説記事を /column/ に置いている状態で考えます。共通の指定で断っても、AIのロボットが記事を読みに来ることはあります。学習にしか使わないロボットが、相手の判断で読みに来なくなることもあります。どちらの場合も、相手に届くのは「学習には使わないでほしい」という意向です。
読み込みそのものを止めたい場合は、これまでどおりロボットの名前を指定します。「使い方の意向」と「読み込みの制御」は、同じファイルに書いても別の話として扱われます。
*robots.txt:サイトの最上位の階層に置く設定ファイルで、ロボットにどのページを読んでよいかを伝えます。 *GPTBot:OpenAIが学習に使う内容を集めるロボットの名前です。Anthropicの ClaudeBot も同じ役割を持ちます。
AI学習の拒否はAI検索に影響するのか|学習と掲載は別の設定で決まる
学習を断るとAI検索から消えるのではないか、という心配が最初に出てきます。学習と検索は別の設定で決まるので、学習を断っても検索への掲載は残せます。AIの回答の材料も多くは別に決められますが、Geminiアプリは学習と同じ指定で決まります。
OpenAI・Anthropic・Microsoftでは学習だけを断れるのか?
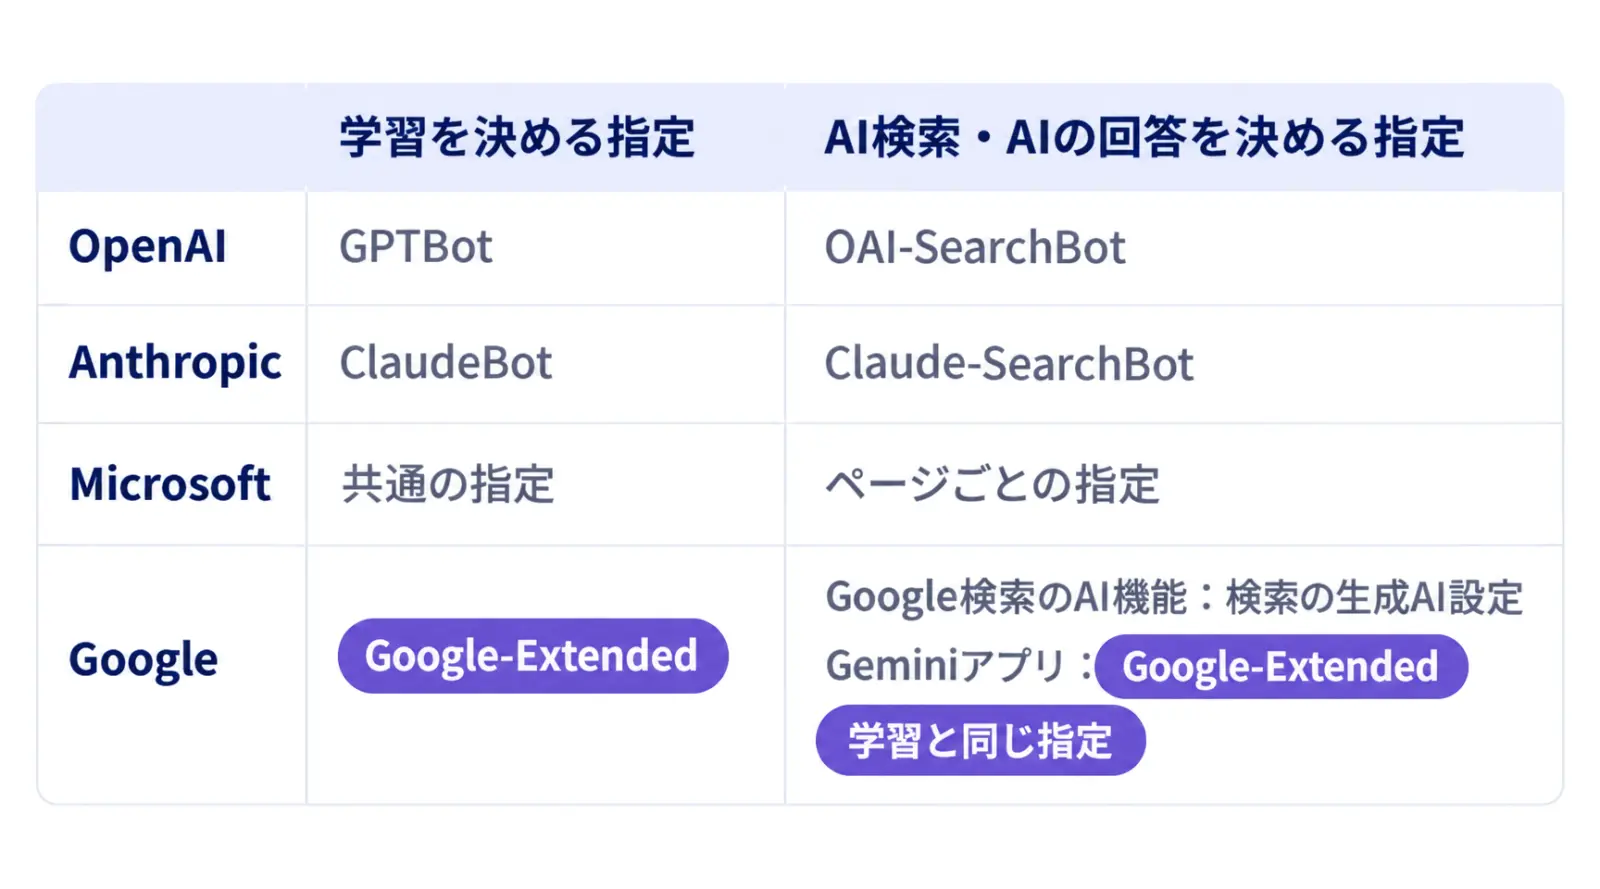
3社とも、学習だけを断れます。止める対象が用途ごとに分かれているためです。
- OpenAIは、GPTBot を拒否したまま検索用の OAI-SearchBot* を許可できます
- Anthropicは、学習用の ClaudeBot と検索用の Claude-SearchBot を別の名前で分けています
- Microsoftは、学習とAIの回答の材料を独立した設定にしていて、どちらを選んでもBing検索の掲載の資格は変わりません
AI検索に社名を出すために開けておくロボットの見分け方と手順は、LLMO対策は何から始めるかを解説した記事で扱っています。学習の話と混ぜず、検索用の名前を止めていないかを別に確かめます。
Google検索のAI機能は何で決まるのか?
AI Overviews や AI Mode への掲載は、Search Console* の検索の生成AI設定で決まります。既定は「含める」です。この設定はAIの学習には影響せず、通常の検索の順位の判断にも使われません。
反対に、学習の側の指定である Google-Extended* は、Google検索への掲載にも順位にも影響しません。Google検索のAI機能に出るかどうかと、学習に使われるかどうかは、別の場所で決める形です。
Geminiアプリの回答は何で決まるのか?
Geminiアプリの回答の材料になるかどうかは、学習と同じ Google-Extended で決まります。Googleは、共通の指定で学習を断り、Google-Extended を明示していないサイトを、Google-Extended を拒否したサイトとして扱う予定です。
つまりGoogleの対応が始まると、共通の指定で断ったページは、Googleの学習と一緒にGeminiアプリの回答の材料からも外れる見込みです。社労士事務所が「解説記事をGeminiアプリの回答に載せたい」と考えるなら、Google-Extended を明示して許可します。
User-Agent: __usage_ai-training
Disallow: /column/

User-Agent: Google-Extended
Allow: /
Google-Extended は学習と回答の材料を1つの指定で扱うため、この書き方はGoogleの学習も許します。Geminiアプリに載りたいかどうかを、書く前に決めます。
*OAI-SearchBot:ChatGPTの検索結果に載せるページを読みに来る、OpenAIのロボットの名前です。 *Search Console:Google検索での自社サイトの表示を確かめ、設定を変えられるGoogleの管理画面です。 *Google-Extended:Geminiの学習と回答の材料への利用を決める、Google独自の robots.txt の指定です。
AI学習を拒否する2行の書き方|断る範囲の決め方と間違えやすい3つ
書く前に、断る範囲を決めます。範囲が決まれば、共通の指定で足す行は2行か3行で済みます。最後に、間違えやすい3つを確かめます。
どこまで断るかをどう決めるのか?
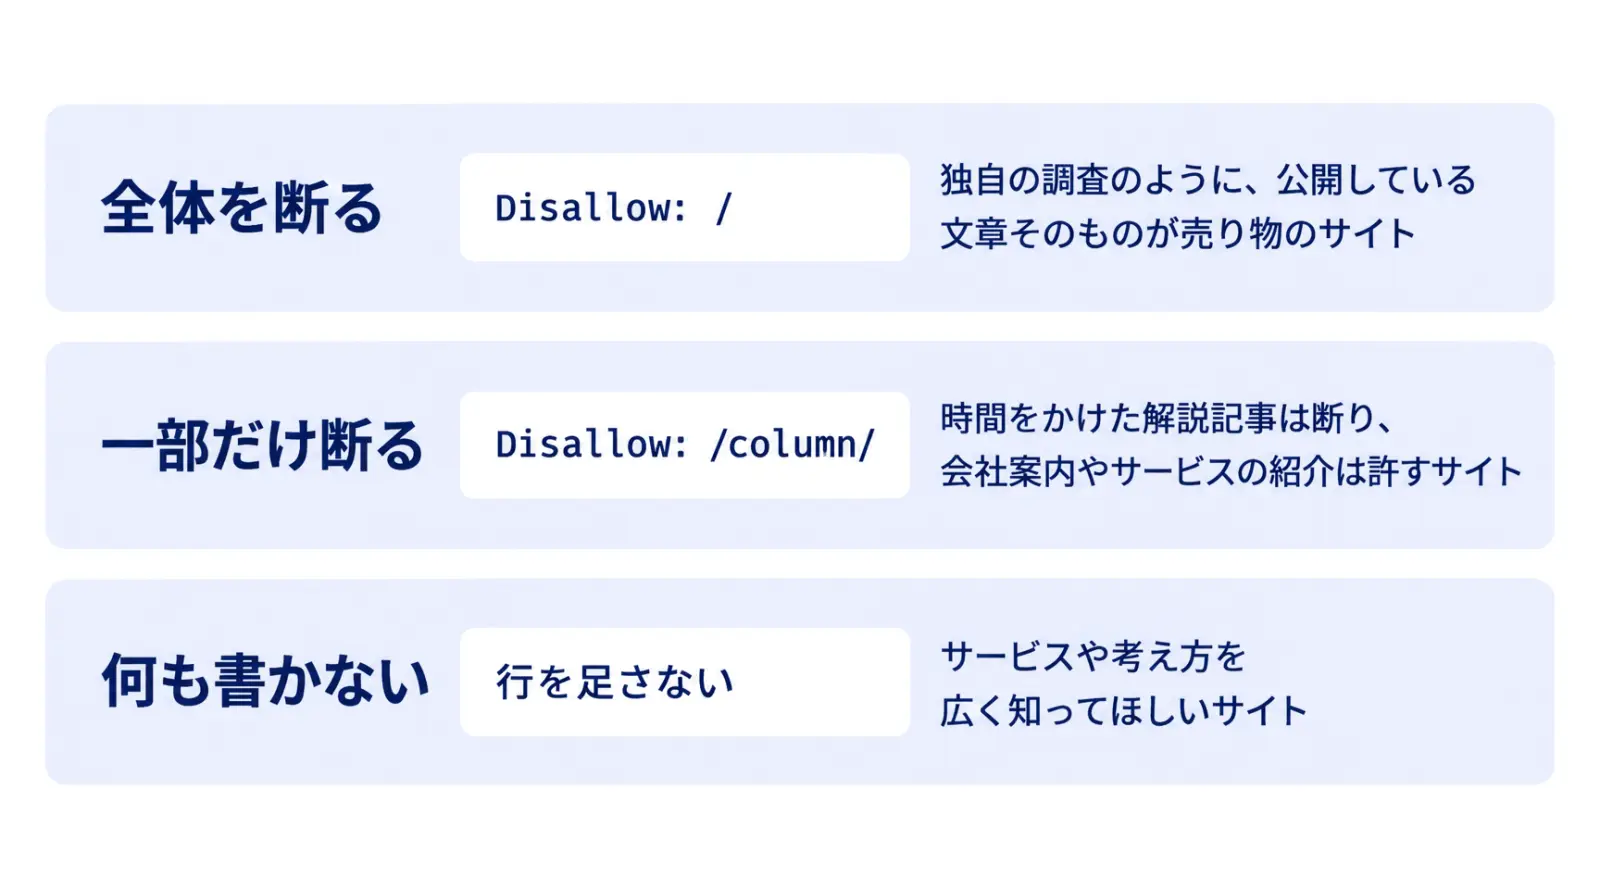
判断の軸は、AIが自社の文章を学ぶことを損と見るか、得と見るかです。サイト全体で1つに決めず、置いてある内容ごとに分けて考えます。
- 全体を断る:独自の調査のように、公開している文章そのものが売り物のサイト
- 一部だけ断る:時間をかけた解説記事は断り、会社案内やサービスの紹介は許すサイト
- 何も書かない:サービスや考え方を広く知ってほしいサイト
社労士事務所の例では、解説記事に経験が詰まっている一方、事務所の名前や得意な分野は広く知ってほしいはずです。この場合は /column/ だけを断る形が合います。
断って得るのは、今後の学習に使わないでほしいという意向を相手に届けられることです。失うのは、学習を通じてAIが自社の名前や考え方を知る機会です。
社内で説明するときは、買う人の質問をAIに投げて自社の名前が挙がるかのように、数えられる物で話すと決めやすくなります。AIの効果を件数で測る考え方は、生成AIの費用対効果を測る4つの問いで解説しています。
どの2行を、どこに書くのか?
robots.txt を開き、ファイルの末尾に次の2行を足します。User-Agent に相手の名前を、Disallow に断る範囲を書く形で、サイト全体の学習を断る意向を伝えます。ファイルを開けないときは、サイトの制作会社か管理者に足してもらいます。
User-Agent: __usage_ai-training
Disallow: /一部だけ断るなら、Disallow の後ろをフォルダの名前に変えます。社労士事務所の例は次のとおりです。
User-Agent: __usage_ai-training
Disallow: /column/全体を断って一部だけ許す場合は、Allow を足して3行にします。より長く一致する指定が優先されるので、/about/ だけが許可の扱いになります。
User-Agent: __usage_ai-training
Disallow: /
Allow: /about/
各社の開始時期と、今すぐ断るときの書き方は4章で扱います。
間違えやすい3つは何か?
書いた後に確かめたい点は、次の3つです。
User-Agent: *の下に書いて済ませる- 検索用のロボットの名前と同じまとまりに入れる
- サブドメインのサイトを見落とす
1つ目は、すべてのロボットを指す * の下の指定が、共通の指定として数えられない点です。共通の指定は、__usage_ai-training の名前を書いたまとまりでだけ読まれます。
2つ目は、User-Agent の行を続けて書くと、下の指定がその全部に効く点です。Google検索のロボットの行と続けて書くと、Disallow が検索にも効きます。検索用の名前とはつなげず、末尾に独立して足します。学習用の名前を並べる書き方は、4-2で扱います。
3つ目は、robots.txt がサブドメインごとに別のファイルとして扱われる点です。www の本体と blog のように分かれているなら、それぞれに書きます。
各社の開始時期と今やること|個別の指定は消さずに残す
開始時期は会社ごとに違います。共通の指定が各社に行き渡るまでの間も断っておきたい場合は、個別の指定と併せて書きます。
各社はいつから対応するのか?
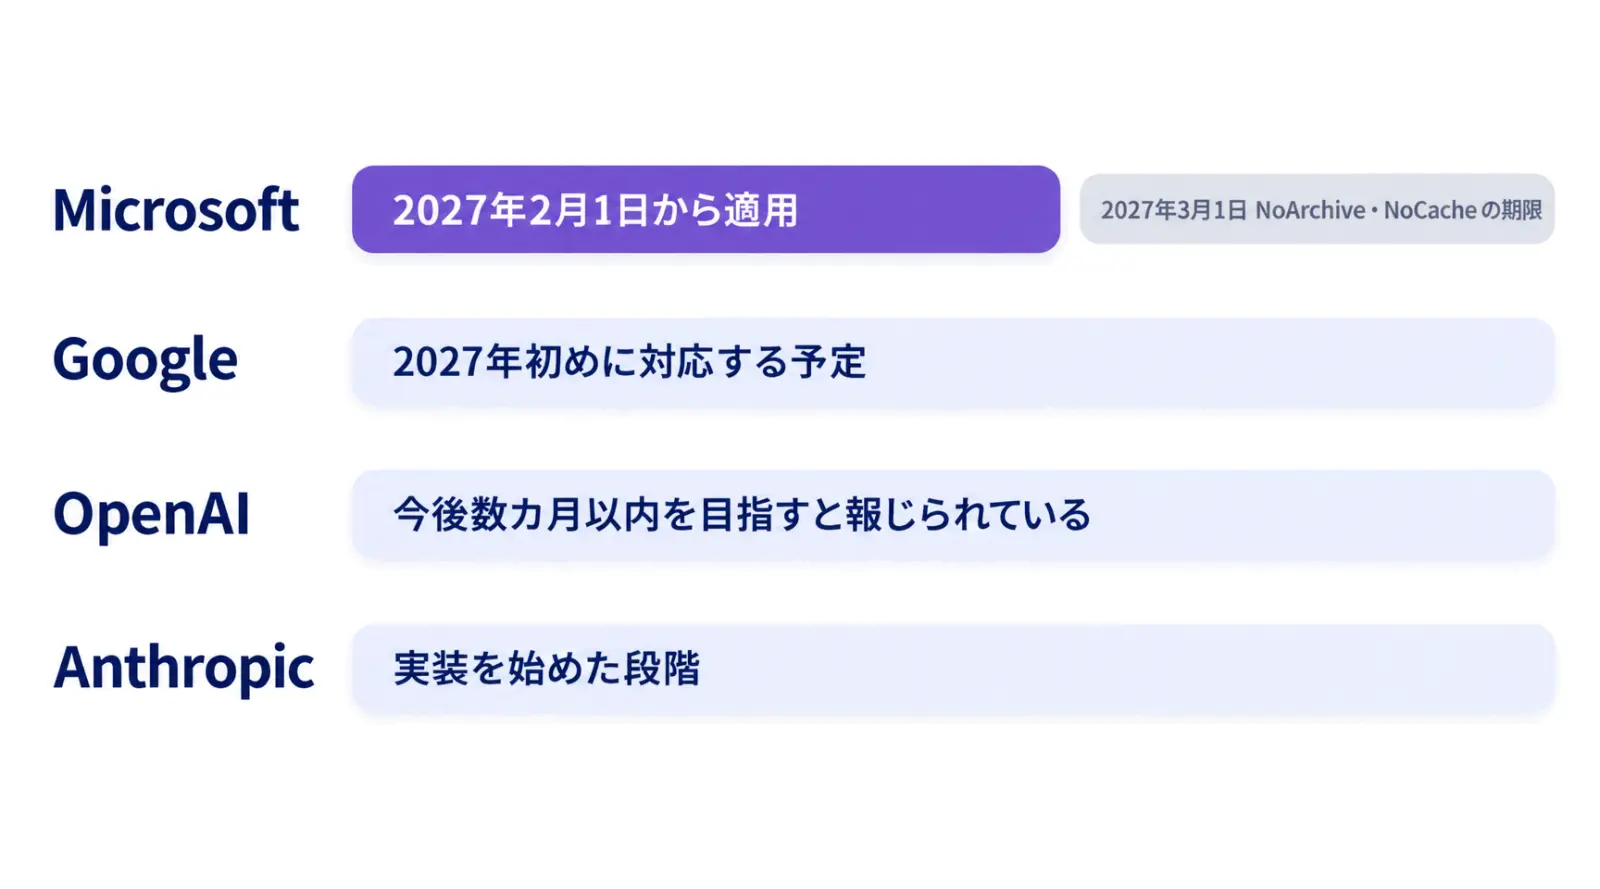
会社 | 対応の時期 |
|---|---|
Microsoft | |
OpenAI | |
Anthropic |
日付まで決まっているのはMicrosoftだけです。適用はページを読み直した時に始まるので、書いた翌日に反映されるとは限りません。それまでのMicrosoftの学習の制御は、ページに書く NoArchive・NoCache* のタグです。
すでに個別の指定を書いているサイトは、消さずに残します。Googleは個別の指定が共通の指定と並んで働き続けるとしていて、Anthropicも共通の指定を今の制御を補う物と位置付けています。
今すぐ断りたいときは何を書くのか?
今の時点で効くのは、各社の個別の名前です。GPTBot・ClaudeBot・Google-Extended を共通の指定と同じまとまりに並べると、今効く指定とこれから効く指定を1か所にそろえられます。
User-Agent: __usage_ai-training
User-Agent: GPTBot
User-Agent: ClaudeBot
User-Agent: Google-Extended
Disallow: /column/
この書き方で気を付ける点は、次の2つです。
User-Agent: *の指定を写す- 読み込みも止める指定になる
1つ目に、ここに名前を書いた GPTBot と ClaudeBot は、User-Agent: * の指定を見なくなります。* の下に Disallow を書いているサイトは、同じ行をこのまとまりにも写します。写さないと、* で止めていたページをこの2つのロボットが読めるようになります。
2つ目に、1章で見た共通の指定と違い、GPTBot と ClaudeBot には /column/ を読まないよう求める指定になります。並べてよいのは学習を断る名前だけで、検索用の名前は入れません。Google-Extended を入れると、2-3で見たとおりGeminiアプリの回答の材料からも外れます。
足した後は何を確かめるのか?
まずブラウザで「自社のドメイン/robots.txt」を開き、足した行が見えることを確かめます。見えなければ、置き場所が違うか、配信の設定で古いファイルが返っている可能性があります。
次に、Google検索のAI機能での表示を、Search Console の生成AIパフォーマンスレポートで見ます。2章のとおり学習の指定はGoogle検索への掲載に影響しないので、足した後に大きく減ったら、検索用の名前まで止めていないかを見直します。
*NoArchive・NoCache:Microsoftが用意してきた、学習と回答の材料への利用を制限するページ用のタグです。
よくある質問|robots.txtのAI学習拒否で迷う点
何も書かないサイトはどう扱われますか?
意向を示していないサイトとして扱われます。Microsoftは、書かれていない場合を許可として扱います。学習を許すサイトは、行を足さなくても困りません。
すでに読まれた内容も学習から外れますか?
対象は、書いた後に取得される内容です。提案の文書が見るのは内容を取得した時点の robots.txt で、Anthropicも ClaudeBot の拒否を今後の内容についての意向と位置付けています。今から取得される分を断りたいなら、4-2の個別の名前を併せて書きます。
ページごとに指定できますか?
Microsoftは対応します。<meta name="Bingbot" content="ai-training:disallow"> をページに書くと、そのページでは robots.txt の設定より優先されます。共通の指定そのものは、サイト全体かパスの単位で書く形です。
NoArchiveやNoCacheを使っている場合はどうしますか?
Bing向けにこの2つを使っているサイトは、2027年3月1日までに新しい設定へ移します。学習は3-2の2行で、回答の材料はページごとの指定で書き、この日より後は2つとも指定として読まれなくなります。回答の材料の制限を続ける場合は、Bing Webmaster Tools* の一時設定にも登録します。登録は2026年12月15日に始まり、その時点で2つのタグを使っているサイトが対象です。
学習を断れば使用料を請求できますか?
この指定は意向を伝えるもので、Microsoftも利用の許諾や支払いを定めるものではないと位置付けています。提案の文書は、個別の合意がこの指定より優先できる形にしています。
*Bing Webmaster Tools:Bing検索での自社サイトの表示を確かめ、設定を変えられるMicrosoftの管理画面です。
さいごに
本記事では、robots.txt の2行でAI学習を断る方法と、AI検索への影響、各社の開始時期を解説しました。2行は学習を断る意向を伝えるもので、読み込みを止める指定ではありません。各社が読み始めるまでの間は、会社ごとの名前を併せて書きます。
AI検索への掲載も別の設定で決まります。GoogleのGeminiアプリは学習と同じ設定でつながるので、ここを先に決めておくと迷わずに書けます。
自社の記事がAIに使われることに不安がある担当者は、まず自社の robots.txt を開き、断りたいページと読まれたいページを書き出すところから始めてみてください。
自社の情報をAIにどう扱わせるかの線引きは、社内の業務でも同じように必要になります。スマートエイトの生成AI研修では、情報管理・著作権・社内ルールなど、業務でAIを使うときのリスクと対策も扱います → 生成AI研修の詳細
※生成AI研修資料/導入事例も無料ダウンロードいただけます。