はじめに
社内ルールに「機密情報は入力しないこと」と書いたのに、現場から「これは機密に当たりますか」と何度も聞かれた経験はないでしょうか。生成AI利用ガイドラインで最後まで決まらないのは、禁止事項の並べ方ではなく「何が機密なのか」という線引きです。
本記事では、生成AIに入れていい情報の3つの条件、入れてはいけない情報の見分け方、自社で線を引く4つの手順を、公的機関とベンダーの公式文書をもとに整理します。スマートエイトは企業向けの生成AI研修と導入支援を行っており、本記事は一次資料を突き合わせた社内リサーチをもとに構成しました。
結論を先に書きます。線引きは「情報の種類」だけでは引けません。同じ顧客リストでも、会社が承認したAIに入れるのか、個人アカウントで開いたAIに入れるのかで扱いが変わるからです。読み終えたときに、自社の情報を3段階に仕分けた表を1枚作れる状態を目指します。
本記事は2026年10月15日時点の公的機関とベンダーの公式情報をもとにしています。法人向けのMicrosoft 365 Copilotは、いまはMicrosoft Copilotという名前に変わっており、本記事でもこの名前で書きます。
「機密は入力禁止」が守られない理由|禁止リストの限界
「機密情報」の定義が人によって違うのはなぜですか?
禁止リストが守られない原因は、現場のモラルではなく定義の不在にあります。「機密情報は入力しない」という条文は、何が機密かを決めていないためです。
国の枠組みも、そこは各社が決める前提で書かれています。経済産業省と総務省が2026年3月に出したAI事業者ガイドラインの第1.2版は、AIを使う側への指針として「個人情報を不適切に入力することがないよう注意を払う」「機密情報等を不適切に入力することがないよう注意を払う」と示しました。一律の入力禁止ではなく、不適切な入力を避けよ、という書き方になっています。
つまり「何が不適切か」を決めるのは会社側の仕事です。ひな型の禁止条文をそのまま写すと、この決めの部分が空欄のまま現場へ渡ります。
取引先名が入った議事録は機密でしょうか。求人票の下書きはどうでしょうか。判断が人によって割れる状態は、条文の書き方ではなく分類の欠落から生まれます。
禁止リストを増やすと、なぜ現場が止まるのですか?
禁止を増やすほど安全になるとは限りません。Google Cloudは生成AIの利用規程の作り方の解説で、「機微な情報を入力するな」という広い言い方がかえって逆効果になると指摘しています。何が機微かを具体的に定義しなければ、従業員は会社のリスク許容度と合わない判断を個人任せで下すことになる、という趣旨です。
同社は、広すぎる禁止が会社の把握しないAI利用、いわゆるシャドーAI*を招くとも指摘しています。禁止しても業務は止まらず、見えない場所へ移るだけだからです。
ここから導かれる順序は単純です。禁止条文を増やす前に、「入れてよい場所」を先に指定します。今週やることは1つで、自社ルールの禁止条文を1つ選び、その1文だけで現場が判断できるかを確かめてください。
*シャドーAI:会社が把握しないまま、従業員が個人の判断で業務に使っている生成AIのこと。
生成AIに入れていい情報は何か|3つの条件
入れてよいかどうかは、情報の種類だけでは決まりません。次の3つが揃っているかで判断します。
- 条件1:会社が承認し、契約したAIであること
- 条件2:入力した内容が学習に使われない契約・設定になっていること
- 条件3:その情報を、使う本人がもともと見てよいこと
公開済みの情報はそのまま入れていいですか?
自社サイトに載せている会社概要、公表済みのプレスリリース、配布済みの製品資料は、どの区分のAIにも入れられます。外に出ても損害が生じないためです。
線引きの作業は、ここから始めると速く進みます。「出ても困らない情報」を先に確定させると、残った部分が本当に判断の要る情報になります。
社内資料は、どこまでなら入れていいですか?
出発点は「そのサービスに保存してよい情報は、そのAIにも処理させてよい」という原則です。会社契約のAIは、既存の契約の内側で動くためです。
Microsoft Copilotは、プロンプトと応答、社内データを基盤モデルの学習に使わず、利用者が閲覧権限を持つ組織データしか表示しません。
Google Workspaceも、顧客の事前の許可なく顧客データをモデルの学習に使いません。
ただし、この原則には例外が2つあります。1つ目は外へ出る経路です。Microsoft Copilotが回答の裏付けにウェブ検索を使うときは、プロンプトから作った短い検索語を、会社の契約の外で動く検索サービスのBingへ送ります。管理者は、このウェブ検索を組織全体や利用者のグループごとにオフにできます。
2つ目は「保存はできてもAIには読ませない」という中間の設定です。Googleは、暗号化した状態のファイルや、ダウンロードを禁じたファイルをGeminiが取得しない仕組みを用意しています。ベンダー自身が中間段階を作っている以上、「保存してよいならAIもよい」を結論にはできません。
会社が契約したAIなら、機密情報も入れていいのですか?
条件が揃えば「可」に振れます。行政の実例が、その変化を分かりやすく見せています。
東京都は2023年、職員向けの文章生成AI利活用ガイドラインで「個人情報等、機密性の高い情報は入力しないこと」と定めていました。
2026年3月30日に出た現行の生成AI利用の手引きは、庁内共通ツールについて「セキュリティ面での検証を行ったうえで、機密性A*までの情報の取扱いを認めています。そのため、機密性の高い情報をプロンプトとして入力することや、個人情報等を含むメールやWeb会議の要約等が可能です」としています。
許可には前提があります。どのツールも入力データが学習目的で保存されないことを確かめたうえでの許可で、許可されていない生成AIの業務利用と、私物端末での業務利用は禁止され、懲戒処分の対象になりえます。デジタルサービス局以外が調達した環境では機密性の高い情報を入れられない場合もあり、承認済みでも条件は残ります。
同じ「機密性の高い情報」という語に対して、3年足らずで規律が逆を向きました。変わったのは情報の種類ではなく、入れ先の検証状況です。
*機密性A:東京都の情報区分の呼び名。手引きでは、機密性の高い情報の入力や、個人情報等を含むメール・Web会議の要約まで、この区分の範囲で認めています。
AIの入れ先は、どう区分すればいいですか?
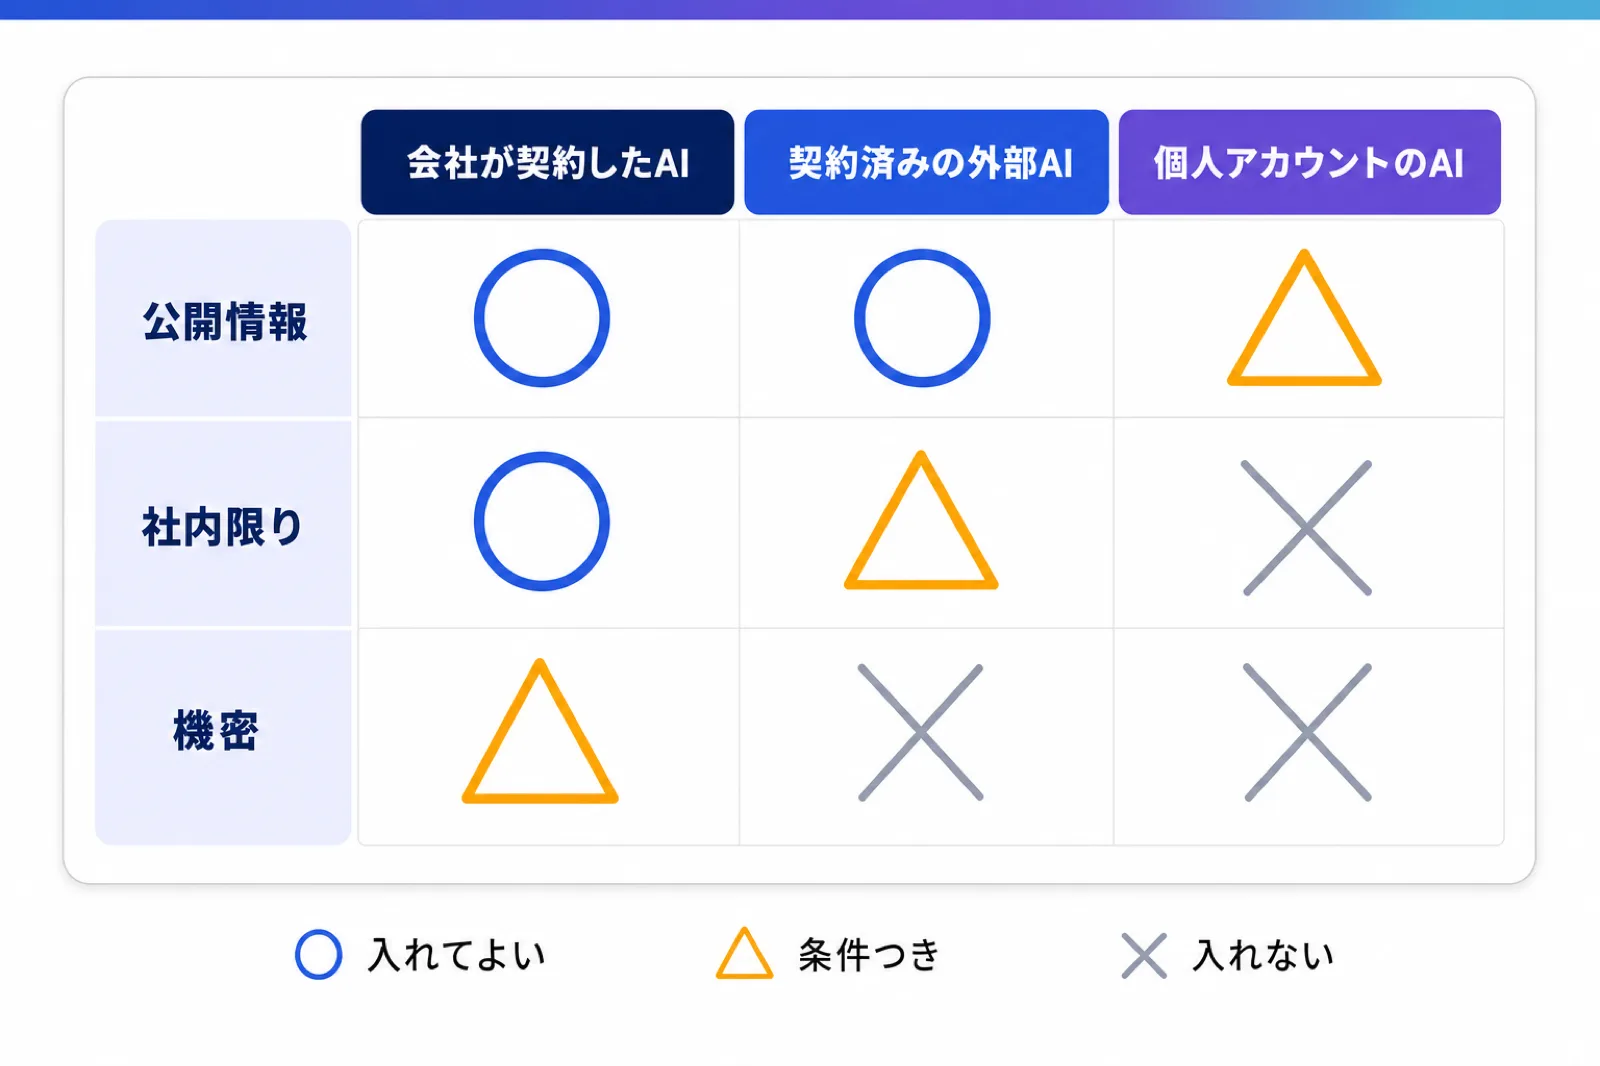
ここまでの話を入れ先で分けると、次の3つの区分になります。
区分 | 例 | 既定の扱い |
|---|---|---|
①会社が契約したAI | Microsoft Copilot、Google WorkspaceのGemini | 条件付きで社内データも可 |
②契約済みの外部AI | 既定で学習に使われない法人向けChatGPT、API利用 | 情報の区分に応じて条件付きで可 |
③個人アカウントのAI | 個人のアカウントで開いたChatGPTやGemini | 業務データの入力は禁止 |
入れてはいけない情報は何か|種類より「量」と「入れ先」で決まる
氏名1件と顧客名簿1万件は、同じ扱いでいいですか?
同じ扱いにすると、ルールは厳しすぎるか緩すぎるかのどちらかに振れます。手掛かりになるのは法律の書き方です。
個人情報保護委員会は2023年6月の生成AIサービスの利用に関する注意喚起で、「あらかじめ本人の同意を得ることなく生成AIサービスに個人データを含むプロンプトを入力し、当該個人データが当該プロンプトに対する応答結果の出力以外の目的で取り扱われる場合」に法違反の可能性があると示しました。分かれ目は入力そのものではなく、応答の生成以外に使われるかどうかに置かれています。
実務に落とすなら、1件の氏名と1万件の名簿は同列に扱いません。外に出たときの影響が違うためです。「個人情報」という塊を1行で禁止せず、1件単位と名簿・一覧で扱いを分けます。契約書や議事録も同じで、抜粋と原本では判断が変わります。
個人アカウントで使うと、何が変わるのですか?
変わるのは契約です。同じ「Gemini」という名前でも、サインインしているアカウントで扱いが根本的に違います。
個人アカウントのGeminiは、既定のままだと人間のレビュアーがチャットの一部を確認し、モデルの改善にも使われます。アクティビティの保存をオフにするか一時的なチャットを使えば、フィードバックを送らない限り、以後のチャットは改善に使われません。
一方、Google Workspaceの法人向けGeminiでは、プロンプトも保存済みのファイルと同じ顧客データとして、契約の内側で扱われます。
教育で最初に伝えるべきは、ここの区別になります。ツールの名前ではなく、どのアカウントで開いたかで判断させてください。
実際の事故はどこから起きていますか?
公開された事故と製品の仕組みから見ると、漏れる経路は大きく2つの型に分かれます。
1つ目は個人向けAIへの入力です。Samsungでは2023年3月11日に社内でのChatGPTの利用を認めてから3週間足らずで、ソースコードなどの機密を入力した例が少なくとも3件起きました。同社は緊急の措置として、1回の質問で送れる量を1,024バイトに絞っています。
2つ目は社内の権限不備です。2章で見たとおり、Copilotは利用者が閲覧できるデータなら答えに使えます。社内の共有設定が広すぎる過剰共有*の状態では、本来は見る必要のない人の答えにも、そのデータが出てきます。
1つ目は入れ先の区分の問題で、2つ目は社内の権限の問題です。会社契約のAIに切り替えても、2つ目の型は残ります。
*過剰共有:社内の共有設定が広すぎて、本来は見る必要のない人にも見えている状態のこと。
自社の線引きを決める4手順|ひな型を写す前にやること
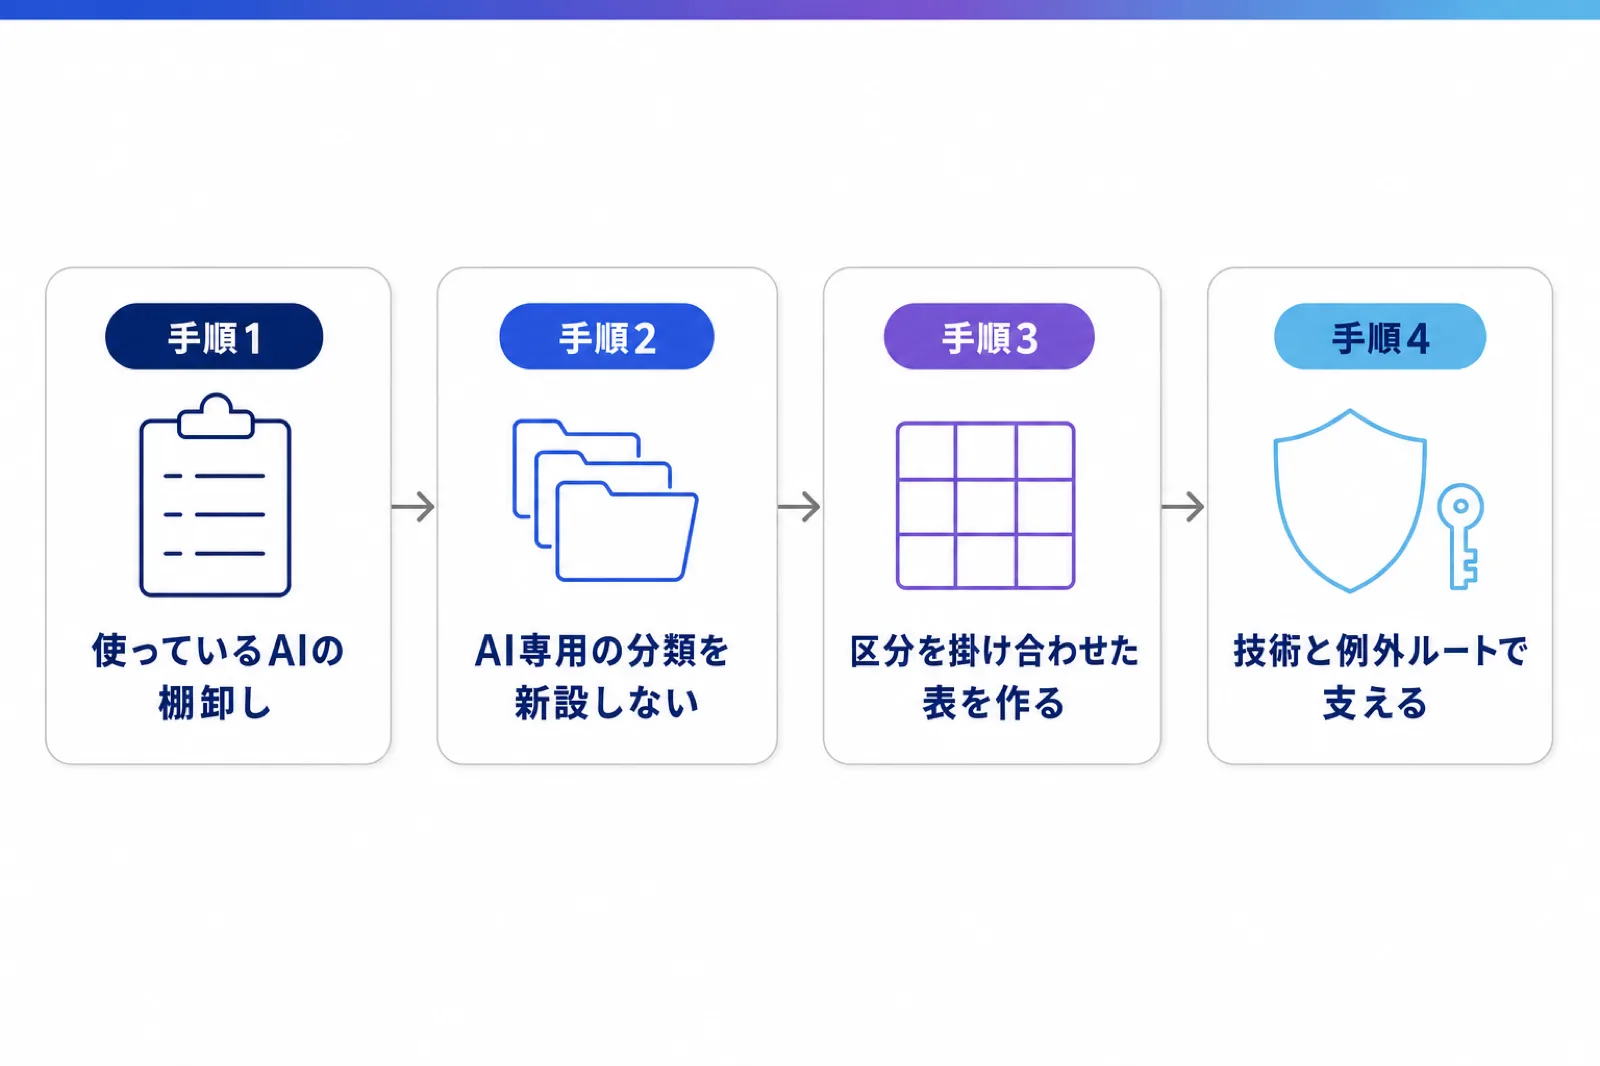
ひな型は土台になりますが、写しただけでは自社の線は決まりません。順番は次の4つです。
何から手を付ければいいですか?
手順1は、使っているAIの棚卸しです。部署ごとに「どのAIを、どのアカウントで、どの業務に使っているか」を1枚に書き出します。無料版と、業務で使っている拡張機能も対象に含めてください。
書き出したら、2章の表にある3区分へ割り当てます。一番太い線は、データの種類ではなくこの区分に引かれるためです。
棚卸しの目的は、禁止するツールを探すことではありません。区分①と②に「入れてよい場所」が1つも無い状態を見つけ、先に用意するためです。
自社の機密はどう洗い出しますか?
手順2は、AI専用の分類を新設しないことです。公開情報、社内限り、機密、極秘といった既存の情報管理規程をそのまま使います。分類を2系統に増やすと、現場は突き合わせられず形骸化します。
分類規程がまだ無い会社は、「社外秘かどうか」の2区分から始めれば十分です。運用しながら細かくしていきます。
手順3は、情報の区分とAIの区分を掛け合わせた表を1枚作ることです。読了後に作ってほしいのが、この1枚になります。
情報の区分 | ①会社が契約したAI | ②契約済みの外部AI | ③個人アカウントのAI |
|---|---|---|---|
公開情報 | ○ | ○ | △ 会社としては非推奨 |
社内限り | ○ | △ 案件・ツール単位で判断 | × |
機密:顧客情報・個人情報を含む | △ 印付け・自動検知・権限の棚卸しが済んだ範囲 | × | × |
極秘:経営情報・未公表情報・要配慮個人情報 | ×または個別承認制 | × | × |
△の条件をどう置くかが、会社ごとに変わる部分です。金融や医療のように規制の強い業種、要配慮個人情報を扱う会社は、△を×へ寄せます。
決めた線を、どう守らせますか?
手順4は、規則を技術と例外ルートで支えることです。文書だけで守らせようとすると、1章で見た状態に戻ります。
優先度の高い順に3つあります。1つ目は、AIを全社へ広げる前の共有設定の棚卸しです。3章で見たとおり、広すぎる共有はAIを通してそのまま見えてしまいます。2つ目は、秘密度ラベル*と呼ばれる機密度の印と、機密情報の自動検知によるAI参照の制御です。3つ目が、個人アカウントAIの検知とブロックになります。
機能の利用条件は事前に確認してください。Microsoftの場合、印を付けたファイルやメールをCopilotの処理から外す機能はE5やA5などの上位プランが前提で、Businessの各プランとE3では使えません。プロンプトに入った機微な情報を守る機能は、すべてのCopilotの利用者が使えます。
記録の設計も忘れられがちです。会社契約のAIは、プロンプトと応答や利用の記録を、管理者があとから調べられる形で残せます。何をどれだけの期間残すかを、規程と一緒に決めておきます。
最後に、例外申請のルートを必ず用意します。「×」に例外の無いルールは、申請の代わりに個人アカウントでの利用を生みます。
*秘密度ラベル:ファイルやメールに機密度の印を付ける機能。印を条件に、AIの参照や共有の可否を制御できます。
よくある質問|学習・無料版・入力してしまった時の対処
入力した内容はAIの学習に使われますか?
会社契約のMicrosoft CopilotとGoogle WorkspaceのGeminiは、入力を学習に使わないと公式に示しています。個人アカウントのGeminiは既定でモデルの改善に使われるため、扱いが逆になります。
確認の順番は2つです。まず、どのアカウントでサインインしているかを見ます。次に、管理者側の設定でどこまで許可されているかを確かめます。
無料版と会社契約版で、何が違うのですか?
違いは価格ではなく、契約と管理の有無にあります。会社契約版はデータの取り扱いを定めた契約の内側にあり、利用の記録を管理者が追えます。
無料版や個人アカウントには、その枠組みがありません。東京都の手引きも、許可されていない生成AIを業務に使うことを禁じています。
ガイドラインはゼロから作る必要がありますか?
必要ありません。AIの業界団体JDLAの生成AIの利用ガイドラインのひな型は、個人情報を原則「入力しないでください」としつつ、解説で「OpenAI のAPIや、Azure OpenAIサービスを利用する場合には個人情報保護法上の規制をクリアできる場合もあります」と添えています。サービスの区分で扱いを変える構造は、標準のひな型にもともと入っています。
このひな型を土台に、個人情報保護委員会の注意喚起とAI事業者ガイドラインの利用者向け指針を照らせば、骨格は揃います。
ひな型に入っていないのは2つだけです。自社の情報分類と、承認したAIの一覧になります。この2つを埋める作業が、4章の手順にあたります。
間違えて入力してしまった場合はどうすればいいですか?
最初に、使ったのが会社契約のAIか個人アカウントかを確認します。会社契約であれば、管理者が記録から影響範囲を特定できます。
個人アカウントの場合は、学習利用の設定を止めてから履歴を削除します。ChatGPTの手順はChatGPTに入れた個人情報を削除する手順にまとめています。
Geminiの場合はGeminiに個人情報を入れてしまった時の手順で扱っています。
そのうえで、いつ・どのAIに・何を入れたかを記録し、社内の報告ルートへ共有してください。次のルール改定の材料になります。
決めた線を現場へ定着させる段階でつまずく場合は、スマートエイトの生成AI研修で扱っています。
さいごに
本記事では、生成AI利用ガイドラインの中心にある線引きを、情報の種類とAIの区分の掛け合わせで決める方法として整理しました。入れてよいかどうかは、会社が承認したAIか、学習に使われない契約と設定か、本人の権限の内側か、という3点で判断できます。
禁止条文を増やしても、判断の材料が現場に無ければルールは守られません。東京都が3年足らずで規律を変えたように、線は情報の種類ではなく入れ先の検証状況で動きます。
まずは今週、使っているAIの一覧と、情報を3段階に仕分けた表を1枚作ってください。ひな型を写す作業は、その後で十分に間に合います。配ったルールを現場に根づかせるところまで設計したい場合は、生成AI研修という形で伴走する方法もあります。
どの業務から手を付けるかで迷っている場合は、AIに任せられる業務が分かる無料診断から始めてください。3分で終わり、登録もメールアドレスも要りません。 ※生成AI研修資料/導入事例も無料ダウンロードいただけます。